

人工智能响应的成本会随着用户账单的增加而降低. 在订阅、处理文本卷、搜索和重复之间,显示的价格不足以衡量预算。 2026年11月10日查阅的官方费率允许这一支出被分解,而不会将廉价的对策与适当完成的工作混淆.
之后内存,则处理器和电费价格系列涉及较不显眼的支出:在每种用途中消耗计算量的软件。 对于一个独立的小企业或协会来说,实际问题在于一揽子计划中仍然包括什么,以及活动的不同.
从2022年到2024年,在定型性能上下降
LAI 斯坦福2025年指数于2025年4月7日发布,提供了历史基准:在MMLU测试中质疑一个达到GPT-3.5的模型的成本从2022年11月的每百万个芯片20美元增加到2024年10月的0.07美元. 门槛值为64.8%正确. 最后一点是双子座1.5-Flash-8B.
| 期间 | 每百万个芯片美元 |
|---|---|
| 2022年11月 (中文(简体) ) | 20点 |
| 2024年10月 (中文(简体) ) | 0.07 (单位:千美元) |
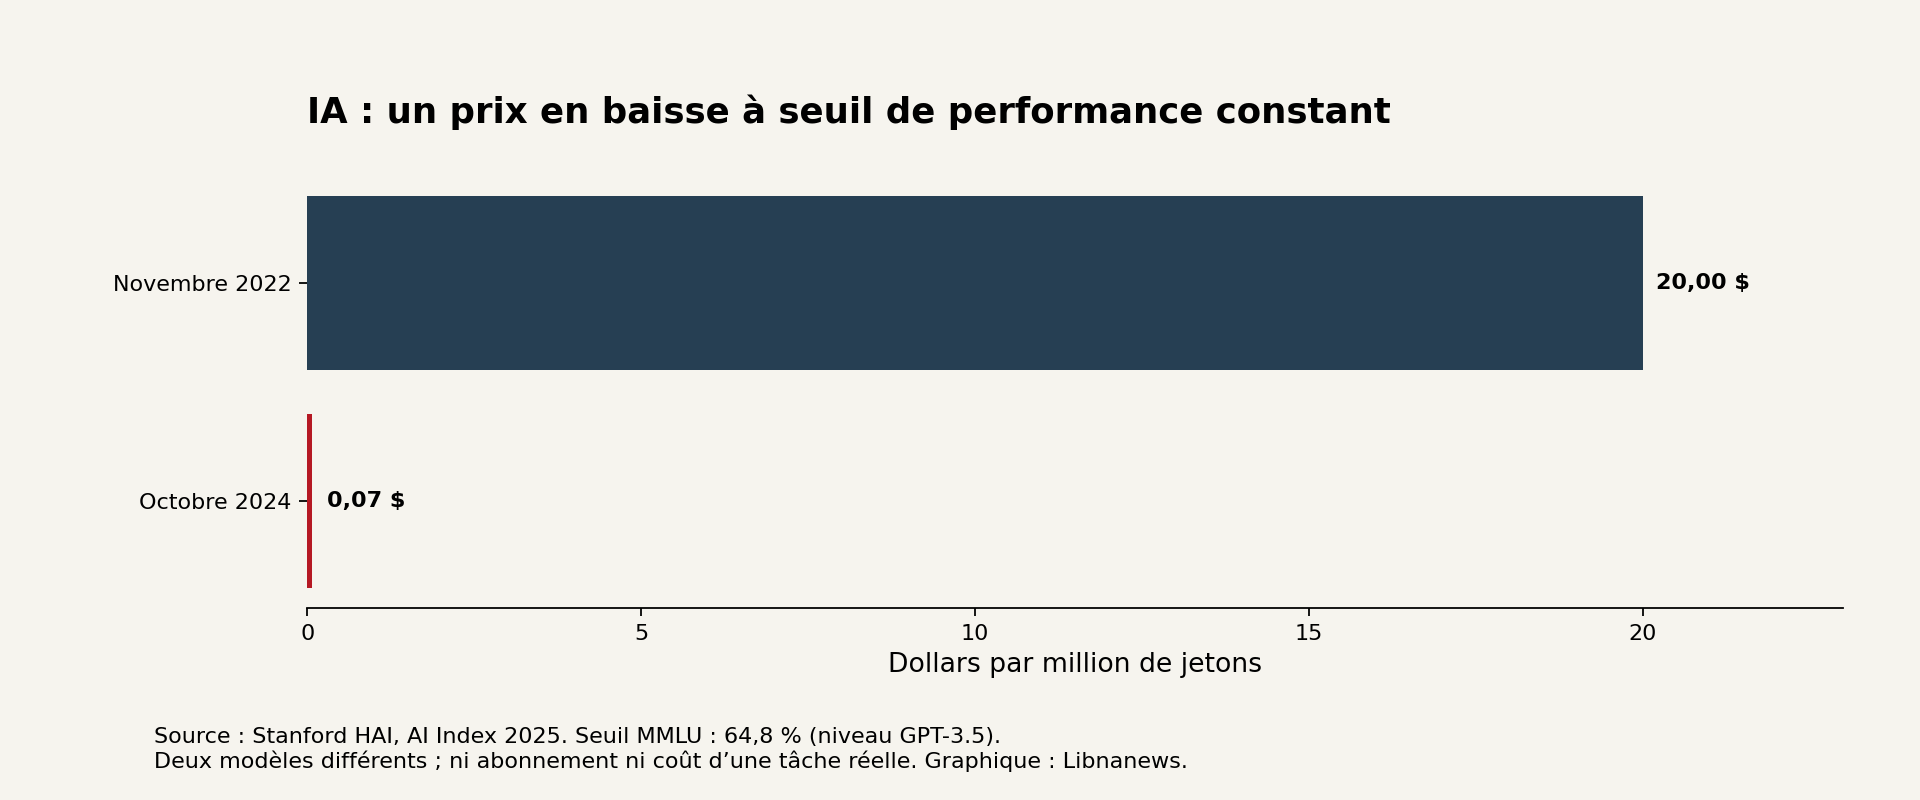
以上是两个在规定性能阈值下的观察,而不是保留了两年的同一种产品的价格. 它们不衡量公司的订货价格或代理人的成功。 该比值已超过280分,但不能被延长至2026分而不保持同样的方法. 因此,以下现行费率是第二个表,独立于这一历史系列.
订阅和消费
在应用程序中,订阅可以提供功能和使用能力. API是允许另一软件查询模型的接口;其消耗一般被计算. 因此,使文件处理自动化的公司必须读取API的条件,即使其雇员已经有订阅.
这个克劳德电网说明这一区别:Pro显示为每月20美元,或当年预缴200美元。 马克斯每月费用为100美元,Ultra为200美元,不包括适用的税收. 使用限额保持不变; 消耗的金额特别取决于模型,谈话时间和文档.
然而,说这两张发票仍然完全分开是不正确的。 现在的Anthropic计划选定用户的 API 信用额:每月100美元给Max,200美元给Ultra,在激活条件下. 它们在周期结束时过期,不提及。 它们不涵盖克洛德代码,克洛德应用程序中的过量,或伙伴平台. 因此,其数额并不构成该标记所有用途的普遍折扣.
一篮一篮的薯片,不是保证得到同样的结果
符号是模型处理的文本单位,不一定是单词. 入口了解向其传递的内容;产出与其发票制作相符。 为使关税可读,下表将基本价格适用于一个纯粹说明性的篮子:100万个未兑现的输入芯片和20万个可计费的产出芯片,再加上几个简短的询问。 它不包括工具、税收、促销信贷、加速模式和增加长期治疗.
| 型号 | 每百万个条目 | 每百万美元的产出 | 篮子成本 |
|---|---|---|---|
| GPT-6 卢纳 | 0.10 (中文(简体) ) | 0.50 (中文(简体) ) | 0.20 (英语) |
| GPT-6.1 土壤 | 2.00 (中文(简体) ) | 10:00 (英语) | 4 00个 |
| 克劳德·索内 5.5 | 2.00 (中文(简体) ) | 10:00 (英语) | 4 00个 |
| 克劳德·奥普斯 5.5 | 4 00个 | 20点 | 8点 |
| 克洛德5.2号 | 8点 | 40.00 (中文(简体) ) | 16.00 (中文(简体) ) |
网格金额OpenAI, 标准模式和短上下文,以及基本死亡率。计算是输入+0.2×输出。 两个相同的价格并不意味着两个可互换的模式。 同一文档还可以根据型号的不同产生出不同数量的芯片. 这种模拟比较了充电的单位;它没有分类实际完成的文件的准确性,速度或成本.
为什么长的答案更重
在4个篮子中,入场费为2美元,出场费为2美元. 然而,有5倍少的筹码出来。 按这些速度计算,需要较长的生产迅速改变开支。 如果出产从20万枚增加到40万枚硬币,加上同样的条目,总额会达到6美元,增加50%. 这是假想计算,不是观察发票.
搜索可以添加. 特别是OpenAI网格显示每1000个标准网络搜索呼叫10美元,外加向模型传输搜索内容的计费. 因此,一千个搜索与一千个简单的文字答案并不相混淆. 一个检查多页,重写和重复的工具可以在发送几个段落之前乘以消费站.
重用文档可以减少其重收
这个缓存指令和文件避免重新计算已经处理过的某些要素。 它涉及请求开始时的一个共同部分,必须保持不变。 仅保持谈话并不能保证这种削减适用.
用于GPT-6.1 索尔,读取缓存的速率为每百万个芯片0.10美元,而普通条目为2美元. 但缓存中的初始写法也有出价:2.50美元,标准存储时间为30分钟. 仅将0.10美元比作2美元即可消除这一首笔支出.
简化的例子:同样的10万令牌部分,完全可再用,写作费用为0.25美元,9个读取费用为0.09美元. 总额为0.34美元,而10个正常薪金为2美元。 这一计算不包括增加的产出和新信息;它假定在过期前有9次成功的再利用。 他没有描述整个谈话的代价.
等待成本会降低
速度是另一种经济选择。 L一组 OpenAI API提供从同步调用中减少50%,并设有24小时处理窗口. 供应商特别负责大型成套设备的分类和评价.
对于在夜间提交文件的公司,这一期限可能是可以接受的。 对于立即回应客户的服务,它会改变所提供的服务. 因此,较低的数额支付另一种交货限制。 所有宣布的削减不应在不核实所选模式和模式允许的情况下机械地相加.
正确的分母:适当完成的任务
在其优化指南Anthropic建议比较每个完成的任务的成本,而不是唯一的象征性价格. 单位价格更高的模式可以减少重复;反之,对每个基本排名使用最昂贵的模型会不必要地增加预算。 制造商提交的结果仍然是其测试的唯一结果,不能取代对客户文件的测试.
具体方法包括取出稳定的样本,界定可接受的反应是什么,然后确定消耗、出错和校正。 在此样本中必须保留困难文件 。 消除它们将人为地提高平均成本,并准确地掩盖最需要工作的情况.
OpenAI 识别其三个杠杆成本减少指南:限制查询次数,减少文本量,并在准确性足够时选择更小的模板. 对于读者来说,这可以转换成简单的问题:你是否必须返回完整的文件,获得十页而不是一个综合,还是重新开始整个任务进行单一的更正?
以下预算包括几个项目:可能的一次总付、实际可用贷项后的净消费、工具以及人的审计时间。 没有公开的尺度来分配这最后一行的普价. 正因为如此,每百万个信物的价格,即使非常低,也不允许自己承诺在最后工作上实现经济.

评论